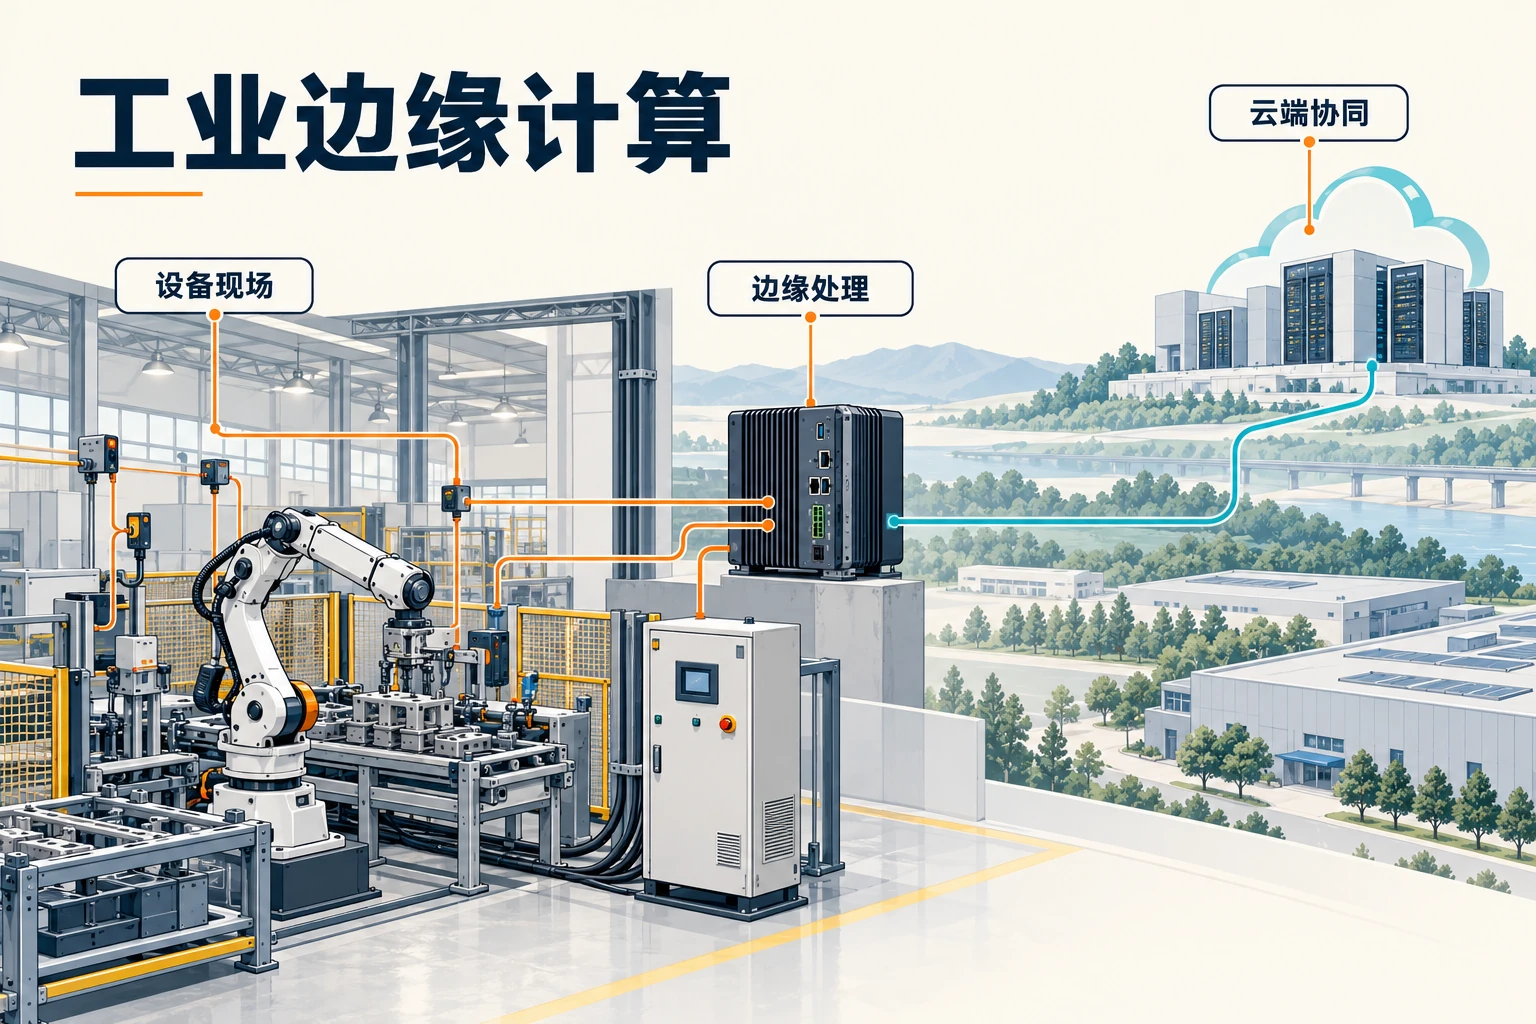
工业边缘计算是在设备、产线或工厂附近部署计算与存储能力,就近处理工业现场数据的一种计算方式。边缘节点可以先完成数据整理、状态分析或图像判断,再把需要汇总的结果传给云平台。边缘与云的分工,取决于任务需要多快得到结果、能否等待网络,以及是否需要多台设备和多个工厂的数据。
“边缘”在哪里,和一台普通网关有什么区别
边缘是相对于数据来源和中心计算平台的位置。设备旁的工业计算机、产线侧网关、车间服务器,都可能承载边缘任务;它不是某一种固定尺寸的盒子。小型节点可以做协议解析和数据过滤,计算资源更多的节点也可以运行视觉算法或多设备分析。
但放在车间的设备不一定都承担边缘计算。一台网关如果只把数据透传到云端,主要完成的是连接与转发;如果它还把原始数据转换为工程值、在本地计算特征或运行判断规则,就承担了现场处理任务。Red Hat 对边缘与云的解释同样区分了“在边缘收集后转发”和“在边缘执行处理”。
云平台也不等于必须部署在公共互联网。企业可以使用公有云、私有云或混合部署;边缘强调计算靠近数据源,云强调计算资源和服务的组织方式。两者能够同时出现在同一套系统中,不能仅凭服务器在厂内还是厂外,就判断全部架构。
现场控制、边缘节点和云平台怎样分工
理解工业场景时,最好把现场控制层一起看。否则容易产生一种误解:原来由控制器执行的任务,只要搬到边缘电脑上,就能获得同样的控制能力。
| 所在层次 | 典型工作 | 决定分工的原因 |
|---|---|---|
| 现场控制器与驱动系统 | 读取输入、执行设备动作顺序、控制运动;由相应安全系统执行安全功能 | 动作要符合确定的时序与故障处理要求,不能依赖远端分析任务及时返回 |
| 边缘节点 | 采集与整理数据、本地缓存、状态分析、视觉推理、现场结果展示 | 数据就在现场产生,处理结果需要及时使用,部分任务要在外网中断时继续运行 |
| 云平台或集中平台 | 跨产线统计、长期趋势分析、集中数据管理、模型训练与版本管理 | 需要汇集较大范围的数据和资源,结果通常服务于持续优化及管理 |
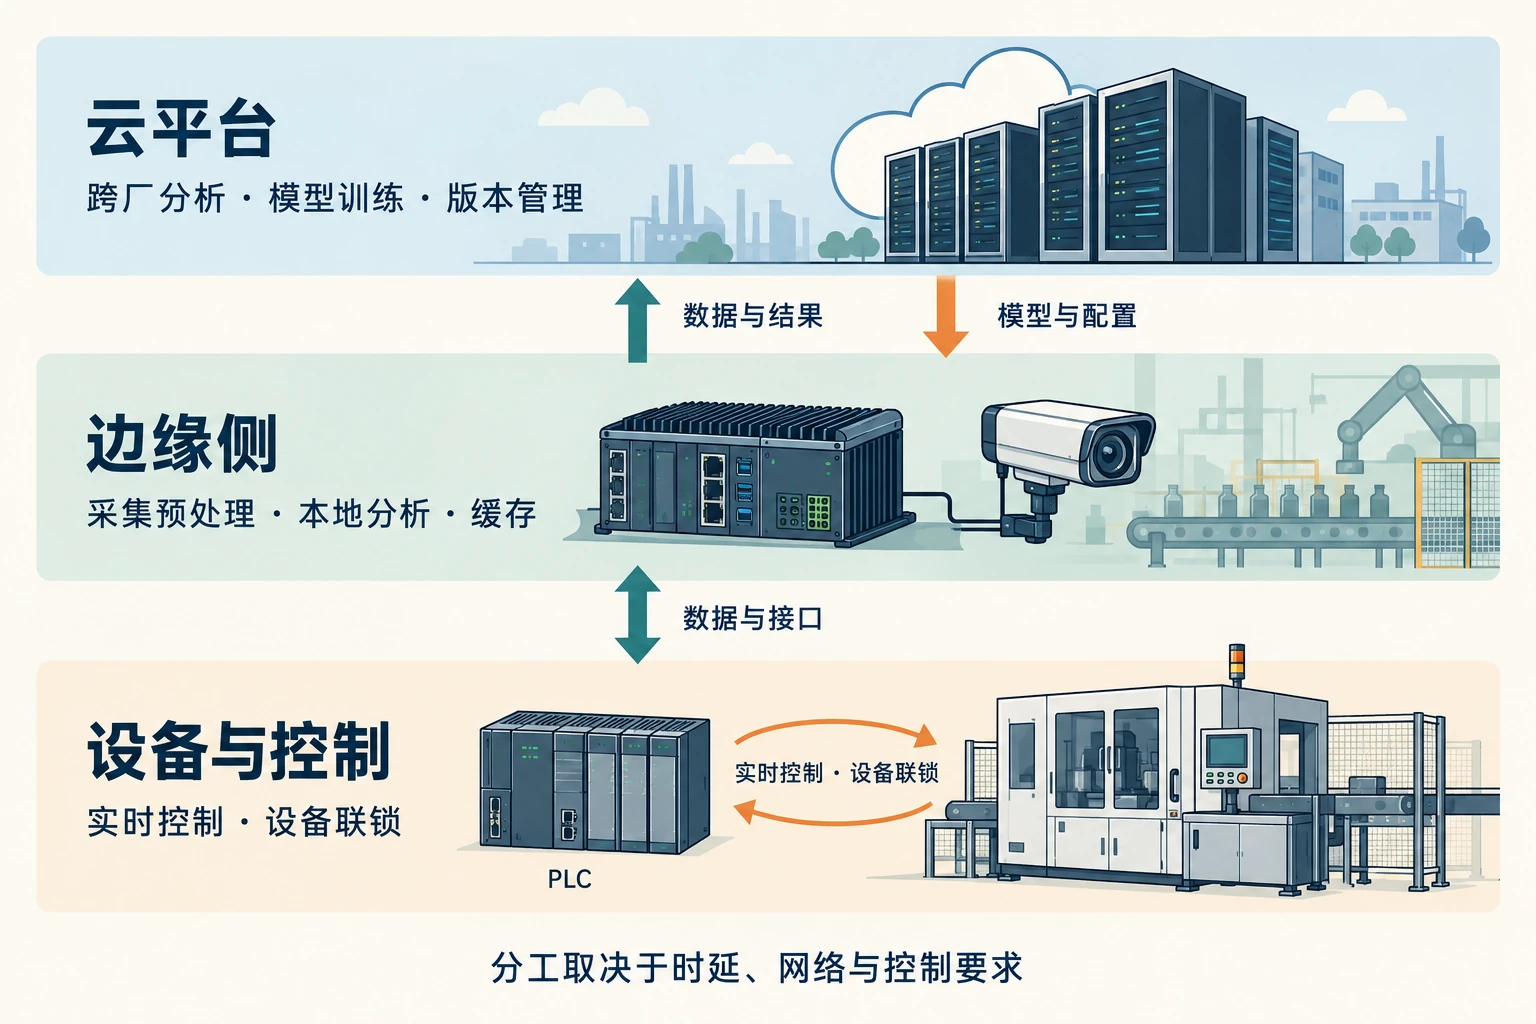
这是一种常见的任务划分,不是三类硬件永远互不重叠。具备相应运行环境和验证条件的边缘系统,也可能承载控制应用;但通用分析程序“离设备近”,并不能证明它满足控制周期、故障响应和安全功能要求。美国国家标准与技术研究院的《运行技术安全指南》SP 800-82 Rev. 3专门强调了工业运行技术的性能、可靠性与安全要求。
边缘缩短了数据往返路径,却没有自动消除延迟。采集、排队、计算、网络传输和执行器动作都会耗时;处理时间的波动也会影响任务。因而“边缘一定在某个毫秒数内完成”“上云必然超过某个毫秒数”都不是可脱离系统条件使用的结论。
用一次视觉质检看懂边云协同
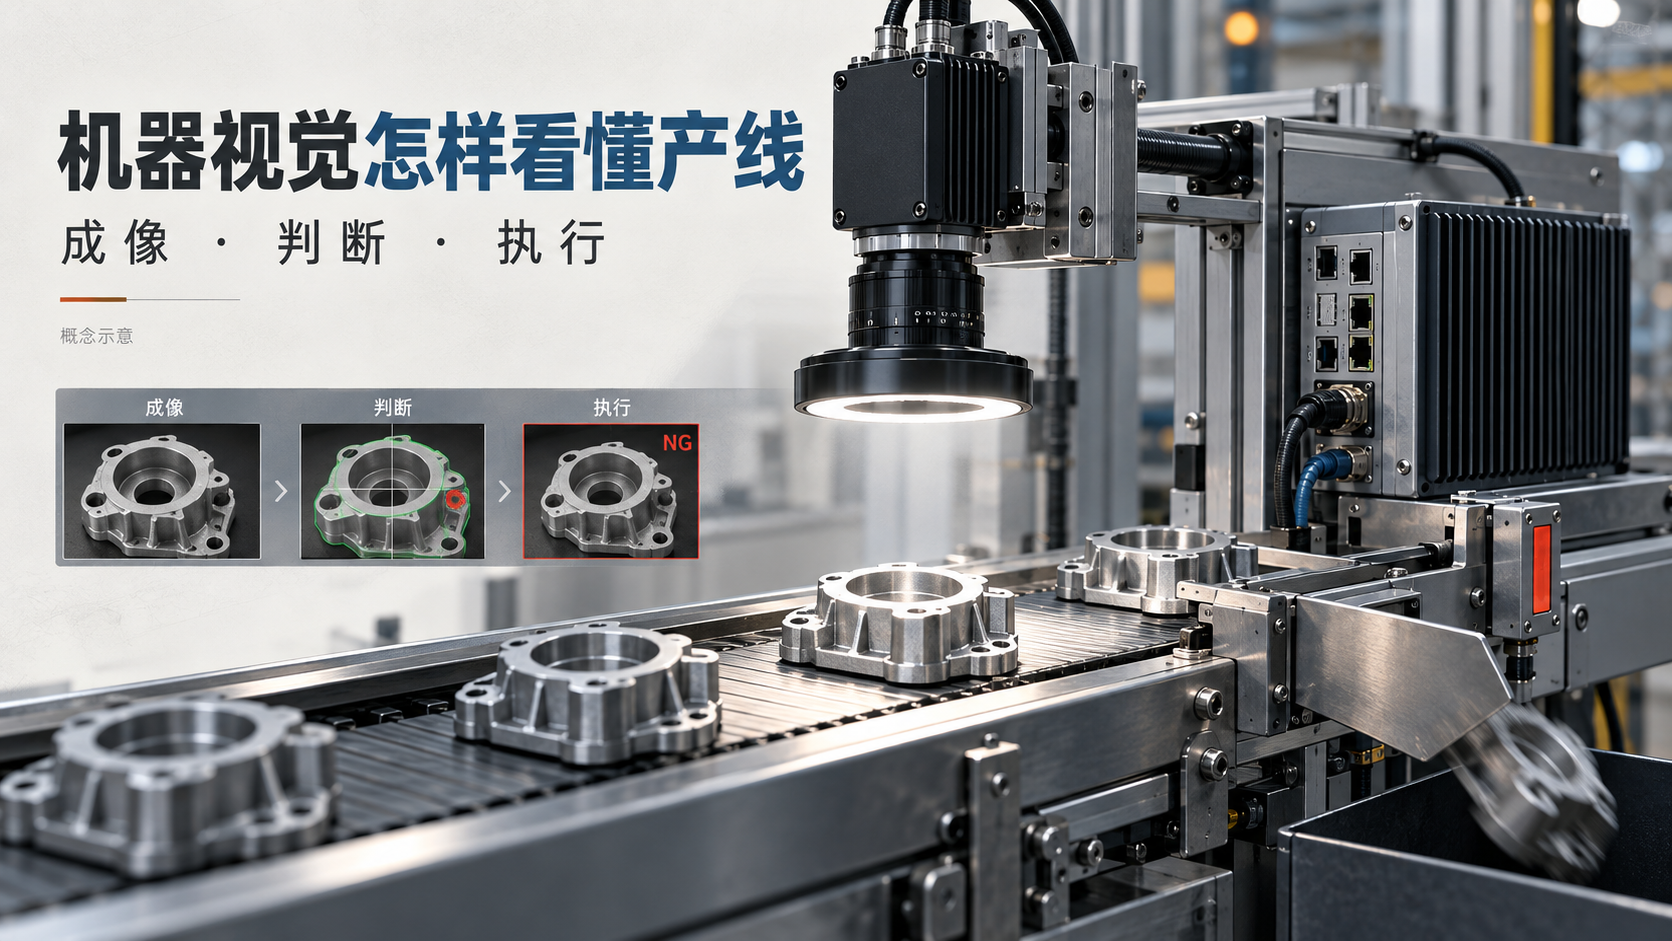
以传送带上的外观检查为例,下面是一种说明分工的设计场景。产品经过相机后,需要在到达剔除工位前得到判断;完整图像可以很大,而质量部门还希望查看不同班次、产品和产线的缺陷变化。即时判断与长期分析便有了不同的数据需求。
- 相机采集,边缘节点判断。图像先在现场交给已部署的模型处理。这里的“推理”是用已有模型判断新图像,区别于利用大量样本训练模型。
- 结果交给现场控制。边缘应用把合格状态、产品标识等结果传给可编程逻辑控制器(PLC)。控制器按已设计的动作逻辑,在正确位置操作剔除机构;超时或结果缺失怎样处置,也必须由该工位的控制规则明确。
- 需要的数据进入集中分析。云端可以接收缺陷类别、数量、产品批次和选定样本,用于跨班次统计或寻找重复问题。原图是否全部上传,应由追溯与分析需求决定,不是边缘计算的固定规定。
- 改进后的模型再回到现场。集中平台利用经过整理的样本训练或更新模型,再将验证后的版本部署到边缘节点。部署时保留版本记录及恢复路径,避免更换模型后无法判断结果变化来自哪里。
AWS 的边云协同说明把本地处理、数据同步和模型更新放在同一个协作过程中。上面的场景据此展开了工程分工:边缘给当前产品提供判断,云端帮助比较多次生产的结果,两者处理的是不同时间尺度的问题。
设备状态监测也有类似逻辑。例如,边缘先从振动信号计算约定的特征,集中平台再对多台同类设备的趋势进行比较。这里“先计算再上传”的收益来自减少不必要的数据搬运;如果诊断必须回看原始波形,就需要保留并上传对应片段,不能只留下一个平均值。
断网后能不能继续运行,要看本地保存了什么
已经在本地部署的程序,可以在不访问云端的条件下继续执行;但这不等于整套业务天然具备离线能力。程序可能仍依赖远端登录、配置、模型下载或查询服务。外网一断,这些依赖如果没有本地替代,相关功能仍会受影响。
一个可核验的实现例子是 Microsoft Azure IoT Edge 的离线机制:设备完成初始同步后,已部署模块可继续本地通信,上行消息先存储,重连后再传送。但消息能保存多久,受到有效期设置和可用磁盘空间限制。这说明“程序可离线运行”与“所有历史数据都能完整补传”是两个问题。
对前面的质检场景,外网中断时可以继续使用现场已有的模型;云端报表则可能暂时停留在旧数据。恢复联网后,还需要明确哪些缓存补传、重复数据如何识别,以及是否会挤占当前生产数据的传输资源。若边缘节点本身故障,影响又与单纯断外网不同,不能用一次断网测试代替全部故障验证。
数据传上云之前,还要保留它的含义
一条“温度 80”的数据,没有单位、设备位置、采集时间和测量状态,就很难用于比较。边缘处理需要保留业务上下文:这是哪台设备的哪个测点、是在生产还是停机时采集、读数是否有效。否则,更多数据只是把不一致一起送到了云端。
开放平台通信统一架构(OPC UA)提供信息建模与数据交换能力。OPC 基金会的配套规范说明指出,行业信息模型用于表达特定设备和领域的信息,让系统在数据含义层面实现互操作。不过,采用通信协议本身并不会替项目自动完成测点命名、单位映射和业务规则,实际接入仍要把这些对应关系定义清楚。
数据汇总也会改变信息。例如,只上传一段时间的平均温度,有利于趋势报表,却可能掩盖短时峰值。如果峰值会影响工艺判断,就应在现场另外保存最大值、事件或必要的原始片段。保留哪些数据,应从后续要回答的问题倒推,而不是把“上传越少越好”当成目标。
因此,读一张工业边缘架构图时,可以沿一个具体任务追踪:原始数据在哪里产生,哪一步必须就地完成,什么结果需要跨设备汇总,以及联网和断网时分别怎样运行。能把这条路径讲清,边缘与云的分工才从设备名称变成了可理解的工作过程。
参考资料
- Red Hat:云 VS 边缘,关系与区别是什么?,边缘位置、处理任务与云环境的关系。
- NIST:Guide to Operational Technology (OT) Security,SP 800-82 Rev. 3,2023,工业运行技术的性能、可靠性与安全要求。
- AWS:什么是边云协同?,本地处理、集中分析与模型更新的协作关系。
- Microsoft Learn:Understand extended offline capabilities for IoT Edge devices, modules, and child devices,离线通信、缓存及限制。
- OPC Foundation:UA Companion Specifications,信息模型与语义互操作。
评论留言
暂时没有留言!